引子:当仿真需要一个能“学习”的大脑
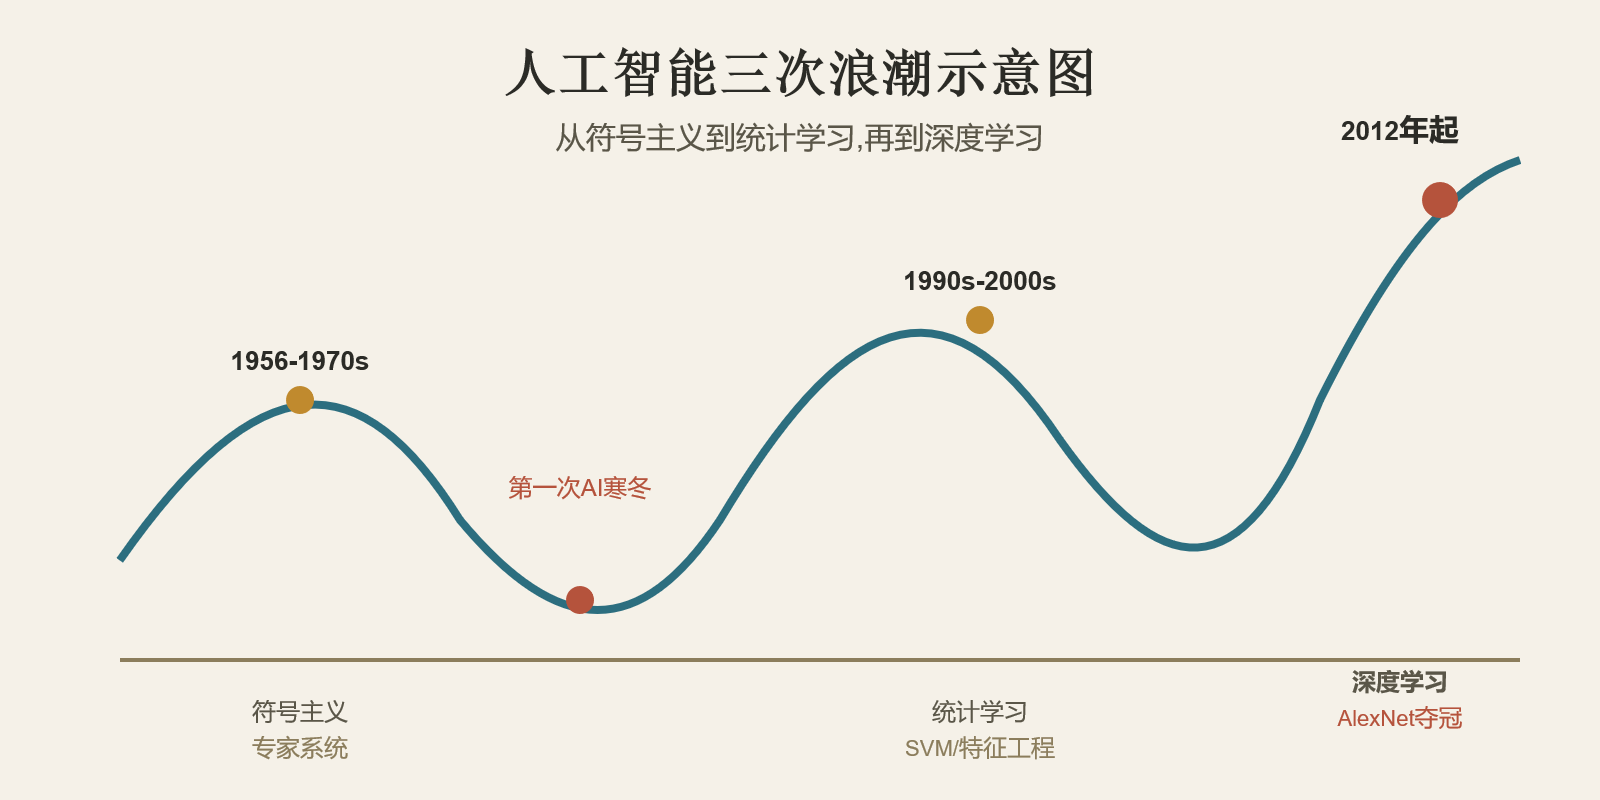
从ENIAC的数值科学计算,到有限元法对复杂结构的离散化求解,再到计算机图形学让仿真结果“看得见”,仿真技术在20世纪走过了一条从“能不能算”到“看不看得见”的漫长道路。然而,这条道路上的所有仿真方法,无论多么复杂精密,本质上都依赖同一个前提:人类必须预先把支配某个系统运行的物理规律,清清楚楚地写成一套明确的数学方程,再交给计算机去求解。可是,现实世界中存在大量我们至今无法用简洁方程完整描述的复杂系统——比如一张人脸的识别、一段语言的理解、一局围棋的胜负判断……要让仿真技术真正具备理解和应对这类复杂性的能力,人工智能——尤其是深度学习的崛起,成为了必不可少的关键一环。这一次,人类要做的不再是“教会机器如何计算”,而是“教会机器如何自己学习”。到目前为止,人工智能发展经历了三次浪潮:早期的符号学习、九十年代开始的统计机器学习、近些年兴起的深度学习。
图1 人工智能三次浪潮示意图
第一次浪潮:符号主义与“知识工程”的理想与困境
人工智能作为一门独立学科的诞生,通常追溯到1956年的达特茅斯会议——一批年轻的科学家(包括约翰·麦卡锡、马文·明斯基等人)首次正式提出“人工智能”(Artificial Intelligence)这一术语,并对机器能够拥有类似人类智能这一前景充满乐观。这一时期占据主导地位的技术路线,被称为“符号主义”(Symbolism)——其核心思想是:人类的智能行为,本质上可以被理解为对符号(比如逻辑命题、规则条文)进行操作和推理的过程,只要能够把人类专家的知识和推理规则,用形式化的逻辑符号完整地编码进计算机系统,机器便能够表现出类似人类的智能行为。
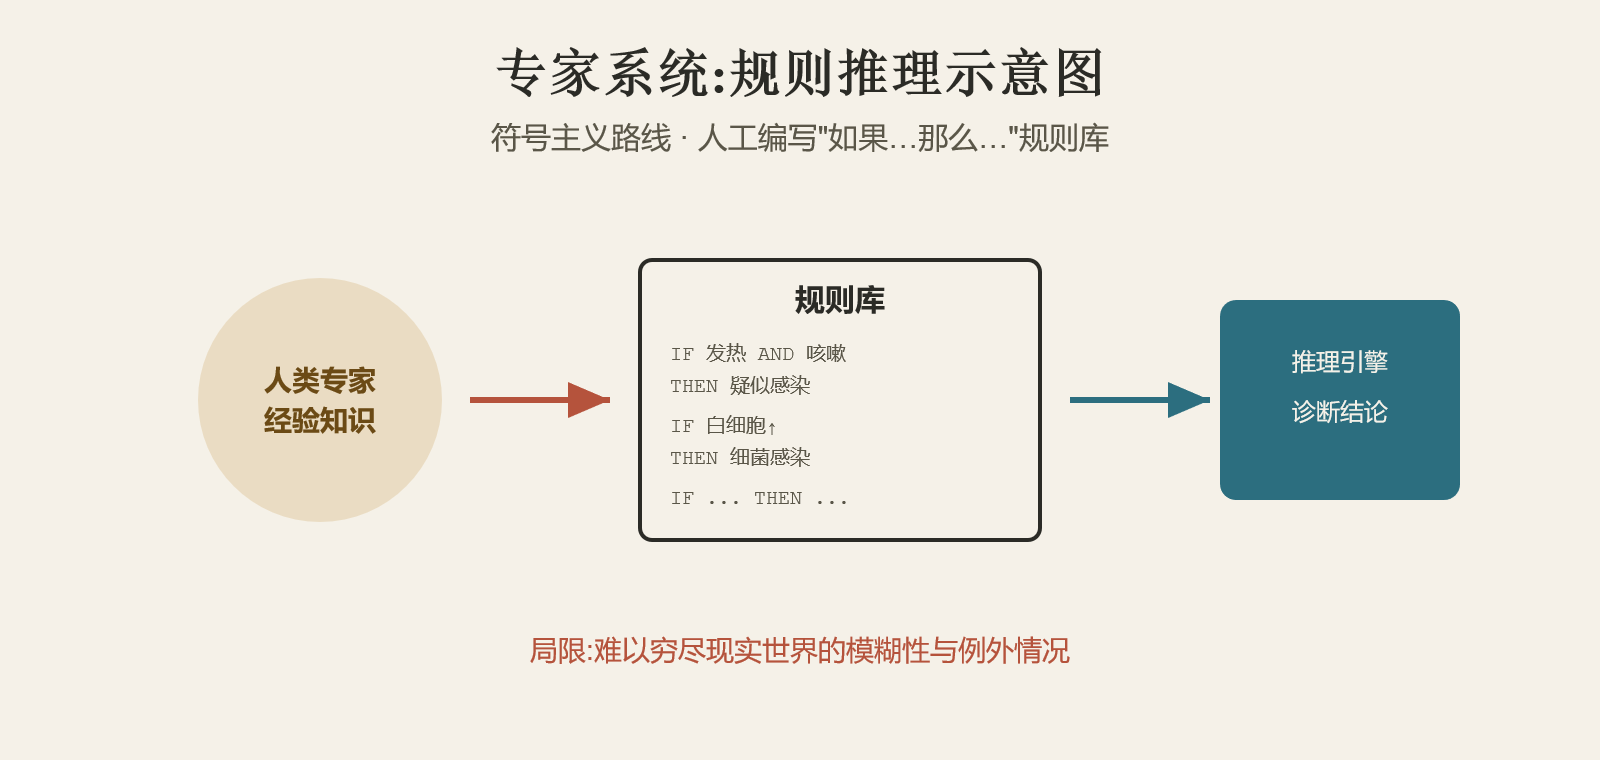
基于这一思路,20世纪70至80年代兴起了“专家系统”(Expert System)的研究热潮——工程师们试图把某一专业领域(如医疗诊断、化学分析)专家的经验知识,总结、提炼成成千上万条“如果……那么……”形式的规则,构建成庞大的知识库,再由推理引擎依据这些规则,对新的问题进行自动化推理判断。斯坦福大学开发的MYCIN系统(用于协助诊断血液感染疾病)、卡内基梅隆大学开发的XCON系统(用于协助DEC公司配置计算机系统)等,都是这一时期专家系统的代表性成果,并一度在商业领域获得了相当程度的成功应用。
图2:专家系统:规则推理示意图
然而,符号主义与专家系统路线很快遭遇了难以突破的瓶颈——现实世界的知识浩如烟海,且往往充满模糊性、例外情况与难以言明的“常识”,试图通过人工编写规则的方式,穷尽覆盖所有可能出现的情形,被证明是一项极为艰巨、成本高昂却收效有限的工程。进入20世纪80年代末至90年代,随着多个大型人工智能项目未能兑现此前过于乐观的承诺,研究资助大幅缩减,人工智能领域进入了历史上第一次被称为“AI寒冬”(AI Winter)的低谷期。
第二次浪潮:统计学习方法的兴起
正当符号主义路线陷入困境之际,另一条技术路线——“统计学习”(Statistical Learning),开始在人工智能研究界逐渐崭露头角,成为20世纪90年代至21世纪初的主流方向。与符号主义试图人工编写规则不同,统计学习的核心理念是:与其让人类专家总结规则,不如让机器直接从大量已有的数据样本中,通过统计学方法,自动学习输入与输出之间隐藏的规律和模式。
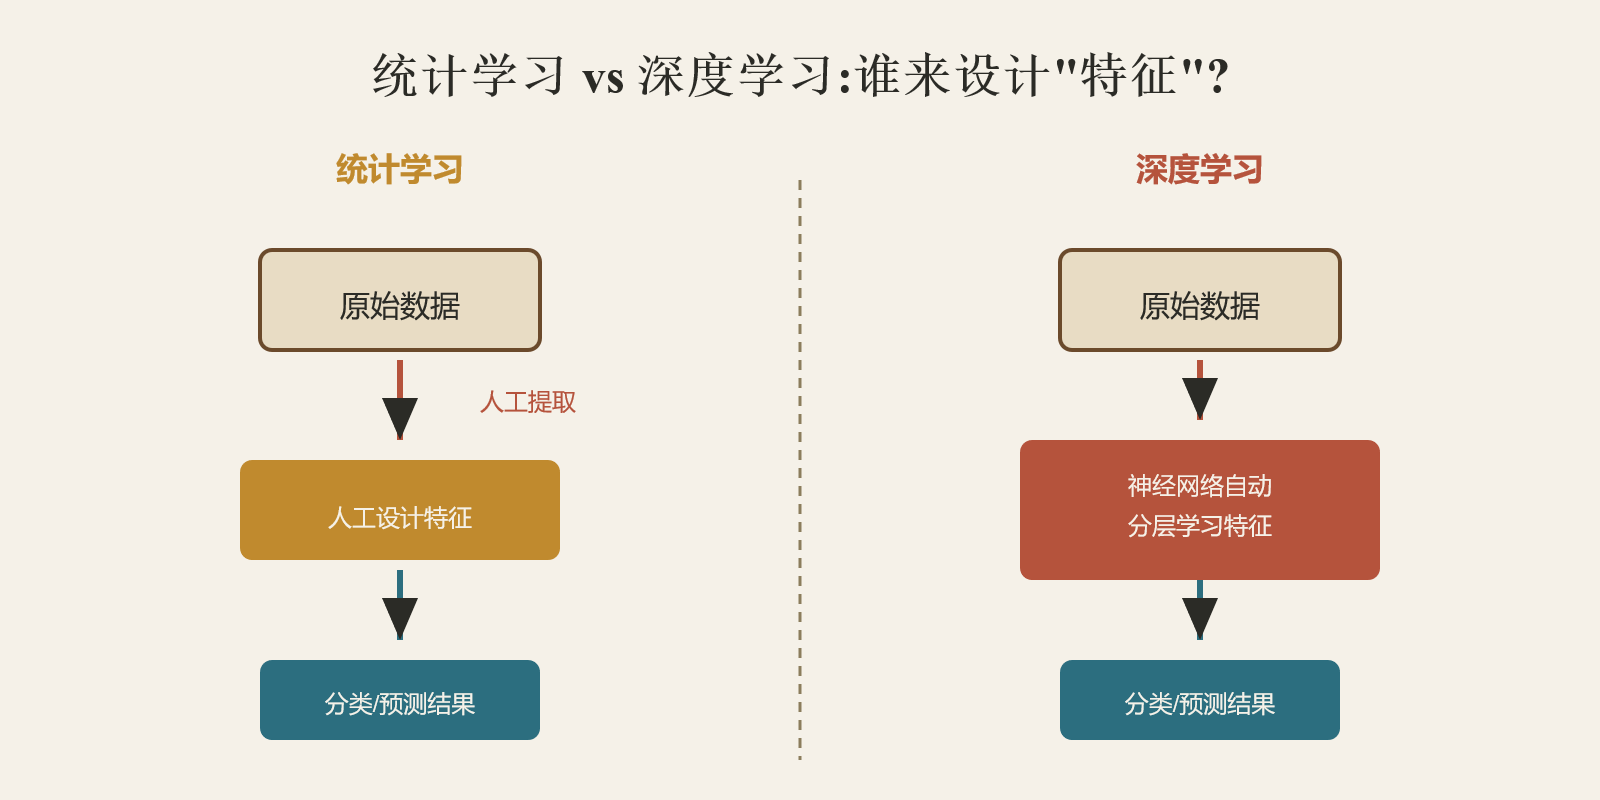
这一时期,包括支持向量机(Support Vector Machine,SVM)、决策树、随机森林、贝叶斯网络在内的一系列统计机器学习算法相继成熟,并在垃圾邮件过滤、手写数字识别、语音识别、金融风险评估等诸多实际场景中取得了相当程度的成功应用。这些方法的一个共同特点是:它们大多依赖人工精心设计的“特征工程”(feature engineering)——即由人类专家预先从原始数据中提取出一组被认为对判断问题最有帮助的关键特征(比如识别垃圾邮件时,统计邮件中特定关键词出现的频率),再交由统计学习算法,依据这些人工设计好的特征,自动学习出分类或预测的规则。
统计学习方法相较符号主义的进步是显著的——它不再要求人类专家穷尽一切可能的规则,而是让机器具备了从数据中自动总结规律的能力。但它依然存在一个明显的局限:模型的最终表现,在很大程度上受限于人工设计的特征质量是否足够优秀,而“如何设计出真正有效的特征”,本身依然高度依赖人类专家的经验与直觉,这一环节难以被自动化,也成为制约统计学习方法进一步突破的关键瓶颈。
第三次浪潮:深度学习——让特征提取本身也能被“学习”
真正意义上打破“特征工程”这一瓶颈、开启人工智能第三次浪潮的,是深度学习(Deep Learning)的崛起。深度学习本质上是人工神经网络(Artificial Neural Network)技术的复兴与深化——神经网络的基本思想,最早可以追溯到1943年沃伦·麦卡洛克与沃尔特·皮茨提出的人工神经元数学模型,以及1958年弗兰克·罗森布拉特提出的感知机(Perceptron)算法,试图通过模拟大脑神经元之间的连接与信号传递机制,让机器具备学习能力。然而,早期神经网络受限于理论认识的局限(1969年明斯基等人指出的单层感知机无法解决“异或问题”等根本性缺陷)以及计算能力的严重不足,长期未能获得突破性进展,一度被主流学术界边缘化。
图3:特征工程对比示意图
深度学习真正迎来爆发,是在2010年代前后。这一次质的飞跃,离不开三大条件的同时成熟:首先,反向传播算法(Backpropagation)历经数十年打磨日趋成熟稳定,使得训练包含多层神经元的“深度”神经网络成为可能;其次,互联网时代积累的海量标注数据,为训练大型神经网络提供了充足的学习素材;第三,以GPU为代表的大规模并行计算硬件——正如我们在计算机图形学相关文章中提到的,这些最初为渲染游戏画面而设计的并行处理器,恰好完美契合了神经网络训练所需的海量矩阵运算需求,极大加速了模型训练的效率。
深度学习相较此前统计学习方法最革命性的突破在于:它不再需要人类专家手工设计特征,而是能够让神经网络自主地、分层地从原始数据(比如图像的像素矩阵)中,逐层学习出从低级到高级、越来越抽象的特征表示——网络的浅层可能学习到边缘、纹理这类简单的低级特征,中间层逐步组合出局部形状、部件这类中级特征,而更深的层次,则能够进一步组合出诸如“猫的整体轮廓”这类高度抽象的高级语义特征。这就极大地释放了机器学习的潜力,使得计算机在图像识别、语音识别、自然语言处理等此前长期被认为极具挑战性的任务上,性能上实现了跨越式提升。2012年,由杰弗里·辛顿(Geoffrey Hinton)团队设计的深度卷积神经网络AlexNet,在ImageNet大规模图像识别挑战赛中,以远超此前所有传统方法的准确率一举夺冠,这一事件被广泛视为深度学习浪潮全面爆发的标志性起点。
从“识别模式”到“理解世界”:AI能力边界的持续拓展
2012年之后,深度学习技术在短短十余年间经历了极为迅猛的迭代演进。卷积神经网络(CNN)在图像识别、目标检测领域持续刷新性能纪录;循环神经网络(RNN)及其改进版本长短期记忆网络(LSTM),让机器在处理语音、文本等时序序列数据方面取得长足进步;而2017年谷歌团队提出的Transformer架构,则彻底改变了自然语言处理领域的技术格局,并最终催生出以GPT系列、BERT等为代表的大规模训练语言模型,让机器在语言理解与生成能力上,展现出前所未有的水准。
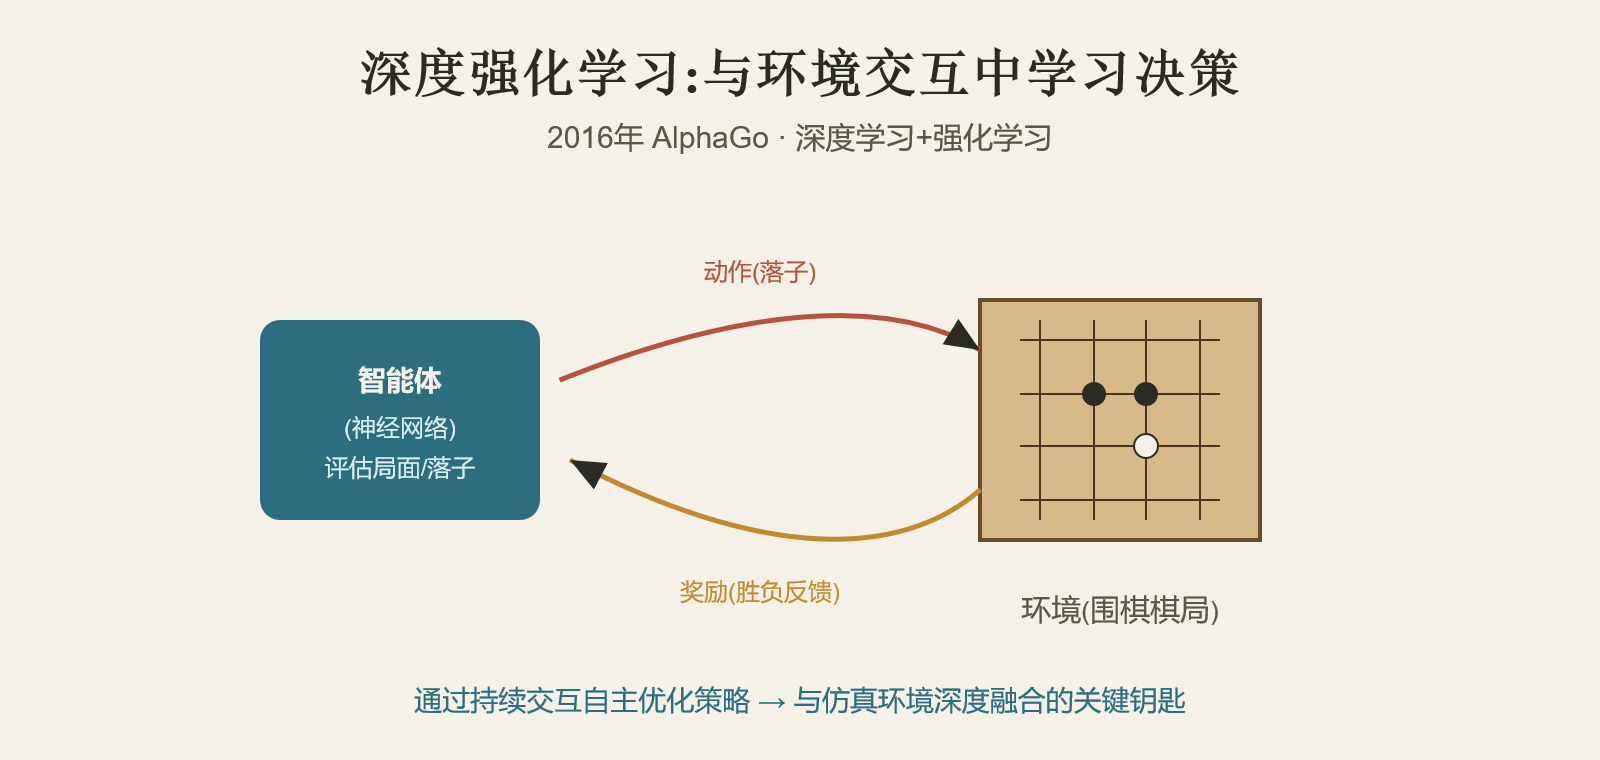
与此同时,深度强化学习(Deep Reinforcement Learning)——将深度学习的模式识别能力与强化学习的决策优化能力相结合——也取得了瞩目的成就。2016年,由DeepMind开发的AlphaGo系统,在围棋这项被认为因其庞大的状态空间而极难被计算机攻克的博弈游戏中,击败了世界顶尖的人类职业棋手,这一成果不仅证明了深度学习在复杂决策任务中的强大潜力,更预示着人工智能技术开始具备在高度复杂、动态变化的虚拟环境中,通过与环境的持续交互进行自主学习和策略优化的能力——而这一能力,恰恰是让AI与仿真技术真正深度融合、迈向“世界模拟器”愿景的关键钥匙。
图4 AlphaGo深度强化学习示意图
结语:AI终于学会了“自己学习”
回顾从符号主义、统计学习到深度学习这三次浪潮的演进,我们可以清晰地看到人工智能技术发展的核心主线:机器的“学习”能力,正在从完全依赖人类预先编写规则,逐步走向能够从数据中自主提炼特征、自主总结规律,乃至通过与环境的持续交互进行自主决策优化。这一演进历程,与我们在前几篇文章中反复讨论的仿真技术演进主线,存在着深刻的呼应关系——仿真技术一直以来致力于回答“如何用模型去逼近真实世界的规律”,而深度学习的崛起,则第一次让“逼近真实世界规律的模型”本身,也可以由机器自动从海量数据中学习和构建出来,而不再完全依赖人类专家预先设定好的确定性方程。当这两条脉络——仿真技术对复杂系统的建模能力,与人工智能对海量数据的自主学习能力——真正开始交汇融合,一个远比此前任何仿真技术都更加宏大的愿景,正在人类面前徐徐展开。
作者: 郑立刚,北京三略融创科技有限公司副研究员;
审核专家: 郭一楠,中国矿业大学(北京)教授。
旺源配资提示:文章来自网络,不代表本站观点。